
比特币挖矿背后的数学原理详解
 AA
从哈希函数说起
比特币挖矿的核心并不是在解高深的微积分方程,而是在执行一种高强度的重复计算。整个过程高度依赖一种名为密码学哈希函数的数学工具,具体使用的是SHA-256算法。你可以将其理解为一个严格的数学映射关系。当你输入任意数据时,算法会按照既定规则进行位运算和模加操作,最终输出一个固定长度为二百五十六位的二进制字符串。这个转换过程具备几个决定性的数学特征。首先是单向性,正向计算极其高效,但逆向推导在现有算力下几乎不可能实现。其次是雪崩效应,输入数据仅变动一个比特,输出结果就会呈现完全随机的剧烈变化。最后是抗碰撞性,极难找到两个不同的输入产生相同的输出。这些严谨的代数特性,直接奠定了区块链不可篡改的底层逻辑。
工作量证明与目标值
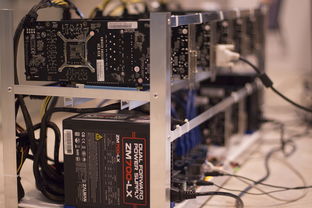
挖矿的实际操作,就是利用计算机的并行计算能力,不断修改区块头中的一个随机数参数,并反复代入哈希公式进行计算。网络中的每个节点都会公布一个当前的目标值,这通常表现为一个极小的十六进制数字,要求计算出的哈希值必须小于该数值。由于哈希函数的雪崩效应,修改随机数会导致输出结果毫无规律地跳跃。矿工就像是在茫茫沙海中筛选特定粒径的沙子,只能通过海量试错来碰运气。当某个矿工偶然发现能使哈希值达标的一组随机数时,他就完成了工作量证明。这一瞬间的胜利意味着他获得了打包新区块的资格,并能获得系统发放的代币奖励。
难度调整机制
为了防止网络因算力波动而失控,协议中嵌入了一套精密的动态调节算法。系统规定每产生两千一百个区块,大约耗时两周,就会触发一次难度重估。核心逻辑是对比实际出块速度与理论预期速度。如果这段时间内生成的区块过多,说明全网算力过剩,协议会自动调低目标值,增加哈希值开头的零的位数,从而拉低中奖概率。相反,若出块过慢,则会放宽限制,减少零的个数。这种基于历史数据的反馈闭环,不依赖任何人为干预,纯粹依靠数学公式维持着网络节奏的稳定。
概率分布与期望时间
从统计学角度来看,挖矿过程严格遵循泊松分布模型。每一次哈希尝试都是一次独立的伯努利试验,事件之间不存在任何关联性。这意味着过去的失败经历不会对未来的成功产生丝毫影响,也没有所谓的运气积累。单个矿工的成功完全取决于其算力份额占全网总算力的比例。大数定律在此处发挥决定性作用,随着尝试次数趋于无穷大,实际产出会无限逼近理论期望值。因此,挖矿本质上是一场概率游戏,短期内的收益波动极大,但长期来看必然回归算力占比的客观事实。
数学构建的去中心化信任
比特币通过一套纯粹的算术逻辑,成功绕过了传统金融对中心化信用中介的依赖。哈希函数的单向性保障了信息安全,目标值的设定控制了发行节奏,难度调整算法维系了网络均衡,而概率统计模型则实现了公平的竞争机制。这四者环环相扣,将抽象的数学定理转化为可执行的计算机指令。矿工付出的电力与硬件成本,实际上是为维护这套数学体系的稳定性支付的保证金。正是这种由代码和数字构筑的严密框架,让去中心化价值传输成为现实,也深刻揭示了现代密码学与博弈论交织的商业智慧。
发布于:2026-11-09,除非注明,否则均为原创文章,转载请注明出处。